学术论文 LaTeX 模板
免费的学术论文 LaTeX 模板,使用标准 article 文档类,标题、摘要、章节和参考文献已排好,让你专注于内容。
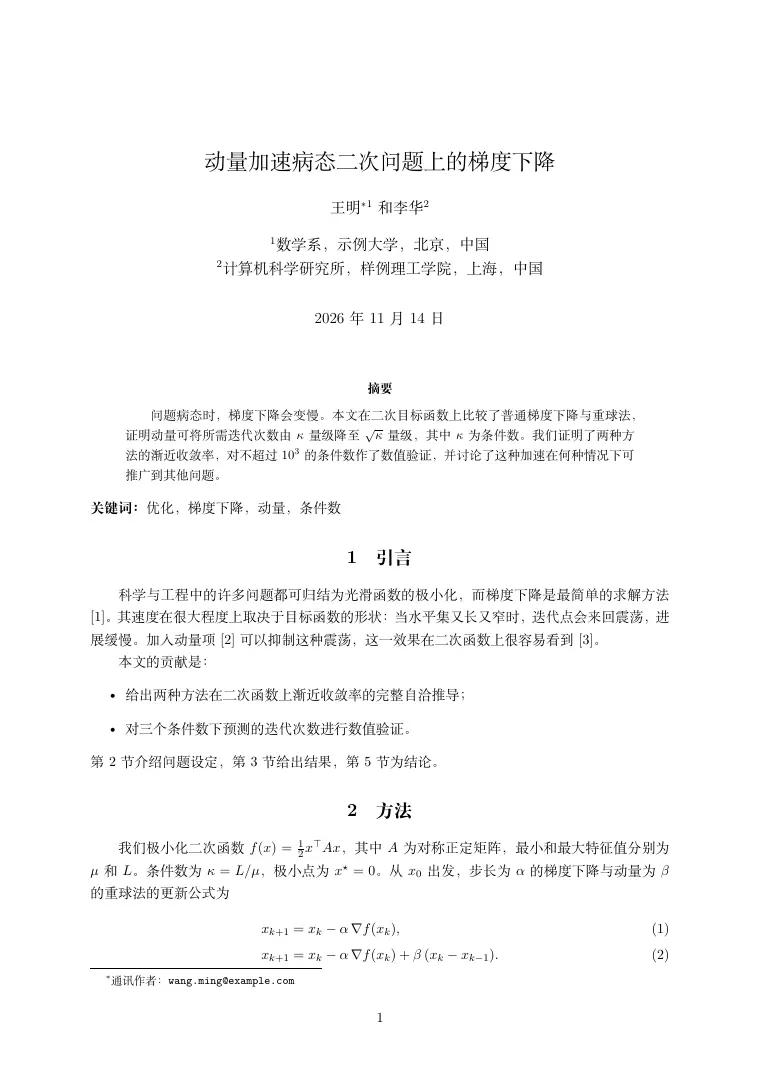
LaTeX 源码
% !TEX program = xelatex
% 科研论文模板:标题、带单位的作者、摘要与关键词、编号章节、定理、表格、图和参考文献。
% 其中包含一个简短示例(二次问题上的动量方法),方便你了解各部分的写法(需用 XeLaTeX 编译,第一行的魔法注释已设置)。
% 请把示例文字、表格和图换成你自己的内容。
\documentclass[a4paper,11pt]{ctexart}

\usepackage[margin=2.5cm]{geometry}
\usepackage{microtype}
\usepackage{amsmath,amssymb,amsthm}
\usepackage{booktabs}
\usepackage{graphicx}  % 仅在使用 \includegraphics 插入图片文件时才需要
\usepackage{authblk}
\usepackage{pgfplots}
\usepackage[hidelinks]{hyperref}
% 参考文献:条目写在 references.bib 中,用 \cite{键名} 或 \citet{键名} 引用
\usepackage[numbers,sort&compress]{natbib}

\pgfplotsset{compat=1.18}
\newtheorem{theorem}{定理}
\theoremstyle{remark}
\newtheorem*{remark}{注}
\renewcommand{\proofname}{证明}
\renewcommand{\Authand}{ 和 }

% ---- 标题与作者:请修改 ----
\title{动量加速病态二次问题上的梯度下降}
\author[1]{王明\thanks{通讯作者:\texttt{wang.ming@example.com}}}
\author[2]{李华}
\affil[1]{数学系,示例大学,北京,中国}
\affil[2]{计算机科学研究所,样例理工学院,上海,中国}
\date{\today}

\begin{document}

\maketitle

\begin{abstract}
  % 用约 150 字概括问题、方法、主要结果及其意义。
  问题病态时,梯度下降会变慢。本文在二次目标函数上比较了普通梯度下降与重球法,证明动量可将所需迭代次数
  由 $\kappa$ 量级降至 $\sqrt{\kappa}$ 量级,其中 $\kappa$ 为条件数。我们证明了两种方法的渐近收敛率,
  对不超过 $10^3$ 的条件数作了数值验证,并讨论了这种加速在何种情况下可推广到其他问题。
\end{abstract}

\noindent\textbf{关键词:}优化,梯度下降,动量,条件数

\section{引言}
% 介绍问题、已有研究、研究空白以及你的贡献。
科学与工程中的许多问题都可归结为光滑函数的极小化,而梯度下降是最简单的求解方法 \citep{boyd2004}。
其速度在很大程度上取决于目标函数的形状:当水平集又长又窄时,迭代点会来回震荡,进展缓慢。
加入动量项 \citep{polyak1964} 可以抑制这种震荡,这一效果在二次函数上很容易看到 \citep{goh2017}。

本文的贡献是:
\begin{itemize}
  \item 给出两种方法在二次函数上渐近收敛率的完整自洽推导;
  \item 对三个条件数下预测的迭代次数进行数值验证。
\end{itemize}
第~\ref{sec:method} 节介绍问题设定,第~\ref{sec:results} 节给出结果,第~\ref{sec:conclusions} 节为结论。

\section{方法}\label{sec:method}
% 描述模型、算法以及复现你的工作所需的假设。
我们极小化二次函数 $f(x) = \tfrac12 x^{\top}Ax$,其中 $A$ 为对称正定矩阵,
最小和最大特征值分别为 $\mu$ 和 $L$。条件数为 $\kappa = L/\mu$,极小点为 $x^{\star}=0$。
从 $x_0$ 出发,步长为 $\alpha$ 的梯度下降与动量为 $\beta$ 的重球法的更新公式为
\begin{align}
  x_{k+1} &= x_k - \alpha\,\nabla f(x_k), \label{eq:gd}\\
  x_{k+1} &= x_k - \alpha\,\nabla f(x_k) + \beta\,(x_k - x_{k-1}). \label{eq:hb}
\end{align}

\begin{theorem}\label{thm:rates}
  取 $\alpha = 2/(L+\mu)$ 时,方法 \eqref{eq:gd} 满足 $\|x_k\| \le \rho_{\mathrm{GD}}^{\,k}\|x_0\|$,其中
  $\rho_{\mathrm{GD}} = \dfrac{\kappa-1}{\kappa+1}$。取 $\alpha = 4/(\sqrt{L}+\sqrt{\mu})^2$ 与
  $\beta = \bigl(\tfrac{\sqrt\kappa-1}{\sqrt\kappa+1}\bigr)^2$ 时,方法 \eqref{eq:hb} 以渐近速率
  $\rho_{\mathrm{HB}} = \dfrac{\sqrt\kappa-1}{\sqrt\kappa+1}$ 收敛。
\end{theorem}

\begin{proof}
  将 $A$ 对角化,对每个特征值 $\lambda\in[\mu,L]$ 分别讨论。对梯度下降,迭代点在该方向上每步乘以
  $1-\alpha\lambda$,其模在 $\lambda=\mu$ 和 $\lambda=L$ 处最大,在给定步长下等于 $\rho_{\mathrm{GD}}$。
  对重球法,数对 $(x_k, x_{k-1})$ 由一个 $2\times2$ 矩阵演化,其特征值是方程
  $z^2-(1+\beta-\alpha\lambda)z+\beta=0$ 的根。对给定的 $\alpha$ 和 $\beta$,这些根是复数,
  且对每个 $\lambda\in[\mu,L]$ 其模均为 $\sqrt\beta=\rho_{\mathrm{HB}}$ \citep{polyak1964}。
\end{proof}

\begin{remark}
  由于梯度下降的 $-\ln\rho \approx 2/\kappa$,重球法的 $-\ln\rho \approx 2/\sqrt\kappa$,
  要达到容差 $\varepsilon$,分别约需 $\tfrac{\kappa}{2}\ln(1/\varepsilon)$ 和
  $\tfrac{\sqrt\kappa}{2}\ln(1/\varepsilon)$ 次迭代 \citep{nesterov2004}。
\end{remark}

\section{结果}\label{sec:results}
% 只陈述结果而不作解释;正文中要引用每一个表和每一幅图。
表~\ref{tab:iterations} 列出了将误差缩小到原来的 $10^{-6}$ 所需的迭代次数,它由定理~\ref{thm:rates} 中的速率算出;
图~\ref{fig:convergence} 给出了 $\kappa=100$ 时的误差上界。

\begin{table}[htbp]
  \centering
  \caption{将误差缩小到原来的 $10^{-6}$ 所需的迭代次数。}
  \label{tab:iterations}
  \begin{tabular}{rrrr}
    \toprule
    $\kappa$ & 梯度下降 & 重球法 & 比值 \\
    \midrule
    10   & 69   & 22  & 3.1 \\
    100  & 691  & 69  & 10.0 \\
    1000 & 6908 & 219 & 31.5 \\
    \bottomrule
  \end{tabular}
\end{table}

\begin{figure}[htbp]
  \centering
  % 图由 pgfplots 绘制,因此不需要图片文件。若要改用图片:
  % \includegraphics[width=0.8\linewidth]{figure.png}
  \begin{tikzpicture}
    \begin{axis}[
      width=0.8\linewidth, height=6cm,
      xlabel={迭代次数 $k$}, ylabel={误差上界 $\rho^{k}$},
      ymode=log, xmin=0, xmax=300, ymin=1e-7, ymax=1,
      grid=major, legend pos=south west,
    ]
      \addplot[thick, domain=0:300, samples=2] {0.9802^x};
      \addplot[thick, dashed, domain=0:300, samples=2] {0.8182^x};
      \legend{梯度下降, 重球法}
    \end{axis}
  \end{tikzpicture}
  \caption{$\kappa=100$ 时 $k$ 次迭代后的误差上界。}
  \label{fig:convergence}
\end{figure}

\section{讨论}
梯度下降所需的迭代次数随 $\kappa$ 线性增长,重球法则随 $\sqrt\kappa$ 增长,
因此问题越难,动量的优势越大:$\kappa=10$ 时约为 3 倍,$\kappa=10^{3}$ 时超过 30 倍。
上述分析只适用于二次函数;对一般的凸函数,重球法需要另外的参数,还可能不收敛,
这正是实践中更倾向于使用加速变体的原因 \citep{nesterov2004}。

\section{结论}\label{sec:conclusions}
% 重申主要结果、其局限以及下一步工作。
在二次问题上,动量把 $\kappa$ 量级的迭代次数变成了 $\sqrt\kappa$ 量级。
今后的工作应检验这种加速在非二次目标函数以及存在噪声时能保留多少。

\section*{致谢}
本研究得到示例基金会资助,项目编号 000000。

\bibliographystyle{unsrtnat}
\bibliography{references}

\end{document}